
《大佛普拉斯》里有一句很有意思的台词,大意是穷人的世界是黑白的,有钱人的世界才是彩色的。
放到大模型行业,过去一年也差不多:免费用户看到的是“AI越来越聪明”,企业客户看到的却是账单越来越厚。最早大家兴奋于模型能力提升,后来真正把财务部门叫醒的,是每个月密密麻麻的token 消耗。
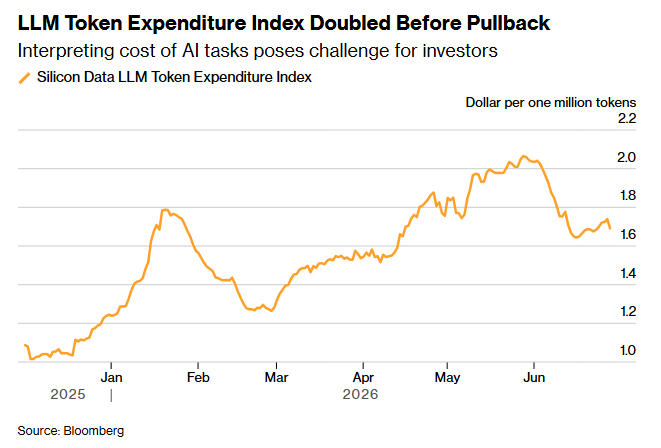
6月,一个不太吵闹的数据开始变得刺眼:LLM Token Expenditure Index 从去年底到5月底几乎翻倍,最高接近2美元/百万tokens,但进入6月后,快速回落到1.6—1.7美元附近。
在我看来,这个数据比很多发布会都重要。因为它指向的不是AI需求消失,而是大模型行业的新旧替代开始进入企业采购表格里。
资本市场接下来真正要看的,也不只是OpenAI、Anthropic的调用量还在不在增长,而是收入增速、ARR、run-rate revenue,是否还能像前几个月那样被线性外推。
AI当然没有结束。更准确的说法是,高价闭源模型“无限定价”的阶段,可能已经在5月底见过一个短期高点。
过去半年,Anthropic被市场看得很重,一个原因是Claude 在企业端和编程场景里确实很强。Anthropic 的run-rate revenue 在2026年上半年快速抬升,Claude Code 也成为企业收入的重要增量来源。
这套叙事很顺:使用量增长,企业付费意愿增强,高价模型占比提升,AI公司收入继续滚雪球。
问题在于,企业采购不是宗教活动。只要账单开始压到利润表,CFO就会进场;只要CFO进场,模型能力就会从“越强越好”,变成“够用就行”。
6月以来,很多企业正在从“先用起来”切换到“算清楚再用”。这个变化不热血,但很真实。
Business Insider报道称,越来越多团队开始从单纯追求token 使用量,转向根据任务复杂度选择模型,也就是把高价模型留给复杂任务,把低价模型放进日常执行流程。UBS近期调研也提到,约60%的企业正在给AI支出加护栏,原因正是成本和回报压力。
这就是Anthropic ARR 的隐忧所在。Claude 依然很强,GPT 也依然是许多企业的首选。但企业workflow不会永远只用一种模型。
一个更现实的组合正在出现:20%—30%的planning、hard reasoning、复杂代码审查、关键决策支持交给Claude 或GPT;剩下70%—80%的执行、客服、文案、数据清洗、普通代码补全、内部知识问答,交给GLM、Qwen、DeepSeek、Kimi等低价模型。
这个结构一旦形成,token总量可能继续增长,但高价token 在收入里的占比会下降。对OpenAI和Anthropic来说,表面使用量依旧漂亮,真实收入质量却可能开始变薄。
更麻烦的是,低价模型的进步速度太快。Reuters近日报道,智谱推出的GLM-5.2 因为能力和价格优势,正在海外开发者社区获得更多关注,在部分平台和编码场景里已经形成明显存在感。
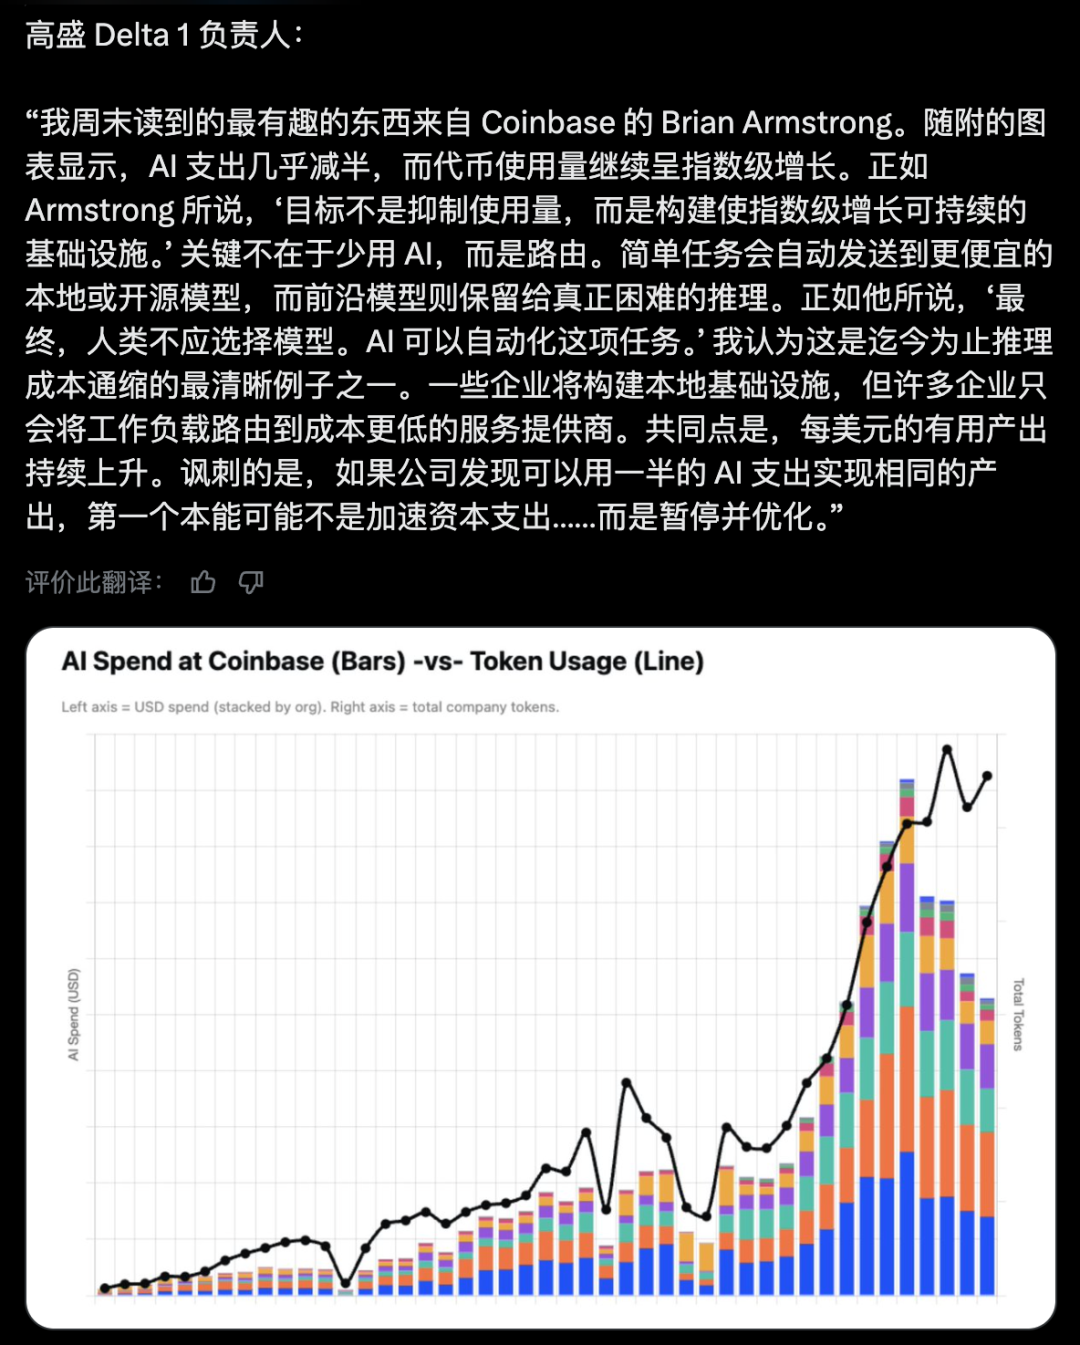
这个现象的含义并不复杂:企业不一定要完全替换Claude 或GPT,只要把一部分任务迁移出去,高价闭源模型的边际定价权就会被削弱。
这里面还有一个容易被忽视的细节:企业降本不只靠换模型,还靠基础设施优化。
Coinbase CEO Brian Armstrong最近分享过一组思路,包括使用更便宜的默认模型、按任务复杂度做模型路由、加强缓存、控制上下文长度、提高AI支出透明度。换句话说,企业并不是减少AI,而是在把AI从“随便刷卡”改造成“精细报销”。
这个变化一旦扩散,模型公司的收入曲线就会遇到三个压力。
第一,新增token 不等于新增同等收入。企业会继续增加AI使用,但会尽量把普通任务路由到低价模型。使用量曲线往上走,收入曲线可能没那么陡。
第二,企业合同的续约谈判会变得更硬。客户已经知道同一个任务可以拆成不同层级,供应商想继续卖高价,就必须证明高价模型在关键环节带来的价值足够大。单纯说“模型更强”,说服力会越来越弱。
第三,模型平台会从卖能力进入卖体系。未来企业真正愿意付高价的地方,可能不是每百万tokens 的单价,而是安全、稳定、权限管理、审计、私有化部署、工程集成和行业知识沉淀。谁能把这些做成企业级产品,谁才更可能保住高质量收入。
所以,接下来7—9月需要盯的,不只是OpenAI、Anthropic有没有更多用户,也不只是Claude、GPT的调用量是否继续冲高。
更关键的问题是:ARR和run-rate revenue有没有低于此前市场的线性外推?企业大客户续约时,单价有没有被压?高价模型在真实工作流里的占比有没有下滑?Claude Code这类核心产品,能不能继续证明自身不是“好用”,而是“离不开”。
在我看来,Anthropic的风险不在技术落后。恰恰相反,Claude 仍然是当前最有企业味的大模型之一,尤其在编程、长文本处理、复杂推理和工作流编排里,产品体验仍然很强。真正的风险在于,企业客户变聪明之后,不会把所有问题都交给最贵的模型。
如果高价闭源模型收入增速放缓,半导体和存储链条也会被重新审视。过去AI硬件的需求假设里,有一条隐藏前提:前端应用收入可以高速增长,模型厂商可以继续花钱买GPU、买HBM、扩数据中心。只要收入能覆盖融资叙事,资本开支就能继续滚动。
但如果ARR增长不及线性外推,投资人会开始追问:算力扩张的回收周期有没有拉长?推理侧价格下降会不会压缩单位算力收入?存储、网络、服务器、液冷这些链条的订单,是否存在节奏错配?
这不是说半导体和存储行情马上结束。AI基础设施的长期需求仍然存在,企业使用AI的深度也还在提高。问题在于,拥挤仓位最怕的不是行业消失,而是斜率变缓。只要收入斜率从“陡峭外推”变成“需要验证”,高杠杆资金就会先降低容错。
大模型行业最像互联网早期的一点,是需求真实存在;最不像互联网早期的一点,是成本从第一天就非常清楚。
网页时代,用户增长可以先讲规模,商业化慢慢补课。大模型时代,每一次调用都在烧算力,每一次上下文变长都在吃显存,每一次agent循环都可能变成账单黑洞。
Agentic Coding任务的token 消耗波动很大,同一个任务的总token 消耗可能相差数十倍,高消耗并不必然带来更高准确率。企业一旦发现“花更多token不一定买到更好结果”,用量治理就会从可选项变成基本功。
所以,我对这轮AI的判断很明确:AI主线还在,但高价闭源模型的商业叙事要降温。下一阶段,行业竞争不再只是模型榜单上的分数,而是收入结构、客户粘性、成本控制、模型路由和企业部署能力的综合较量。
OpenAI和Anthropic仍然是最重要的公司,但重要不等于没有波动。越是被市场当成确定性资产,越需要用真实收入证明确定性。6月token 消费指数的回落,像是一个提前响起的小铃铛,声音不大,但足够提醒市场:企业开始算账了。
我的观点是,7—9月会成为AI商业化的一次压力测试。只要Anthropic ARR继续强劲,Claude Code维持高增长,高价模型叙事还能续上;一旦收入增速低于此前外推,AI硬件链条会跟着降温,特别是存储、服务器和部分高弹性半导体环节。
真正健康的AI产业,不应该建立在“所有任务都用最贵模型”的假设上。更稳的未来,是高价模型处理高价值问题,低价模型承担规模化执行,中间由路由、缓存和预算系统完成调度。
这一天来得越早,AI商业化越接近成熟。只是对某些已经把未来几年收入提前写进模型里的公司来说,成熟本身,也是一种压力。
(娱乐责编:拓荒牛
 )


 晋ICP备17002471号-6