
AI ASIC,下一条硬件主线来了
谷歌今年预计出货332.6万颗TPU,亚马逊Trainium 3预计约147万颗。国内也已经进入量产阶段,阿里自研AI芯片截至今年5月累计出货56万片,字节SeedChip年内量产目标不低于10万颗。
这些公司其实都可以买英伟达GPU,为什么还要花几年时间、几十亿美元去自己做芯片?
首先还是成本;
大模型有两个主要计算阶段,一个是训练,一个是推理。训练就是把模型练出来,需要不断调整模型结构、算法和参数;推理则是模型上线以后真正给用户用。问ChatGPT一个问题、让豆包写一段文字、生成一张图片,后台都要跑一次推理。
训练一代模型可能只集中进行一段时间,推理是每天都在发生的...
用户规模上来以后,一个模型每天可能被调用几亿、几十亿次。对于谷歌、Meta、亚马逊这类公司来说,一颗芯片如果能把每次推理的成本降下来一点,乘上每天巨大的调用量,一天省下来的钱就不是小数目了。
这也是现在AI ASIC开始大规模部署的原因。
一、ASIC和GPU的区别
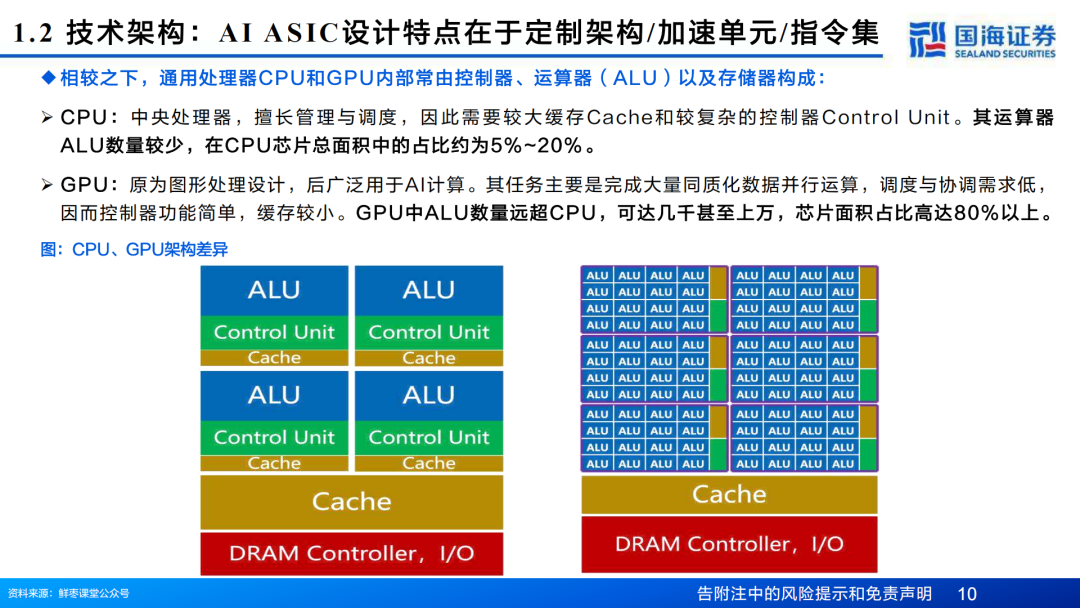
英伟达GPU最大的优势是灵活
今天训练语言模型,明天训练视频模型,后天模型结构又改了,GPU都可以通过软件重新适配。英伟达还有CUDA这套软件工具,开发者已经用了很多年,目前90%以上的AI框架都原生支持CUDA。
但这种灵活性也有成本
GPU为了适应各种任务,芯片上留了大量通用计算和控制电路。互联网公司如果已经清楚一颗芯片主要用来干什么,就可以把用不上的部分拿掉,把芯片面积集中留给AI最常用的计算。
ASIC就是沿着这个思路做的...
ASIC中文叫专用集成电路。用在AI上,可以理解为针对某一类AI计算单独设计芯片,不再追求什么任务都能做。
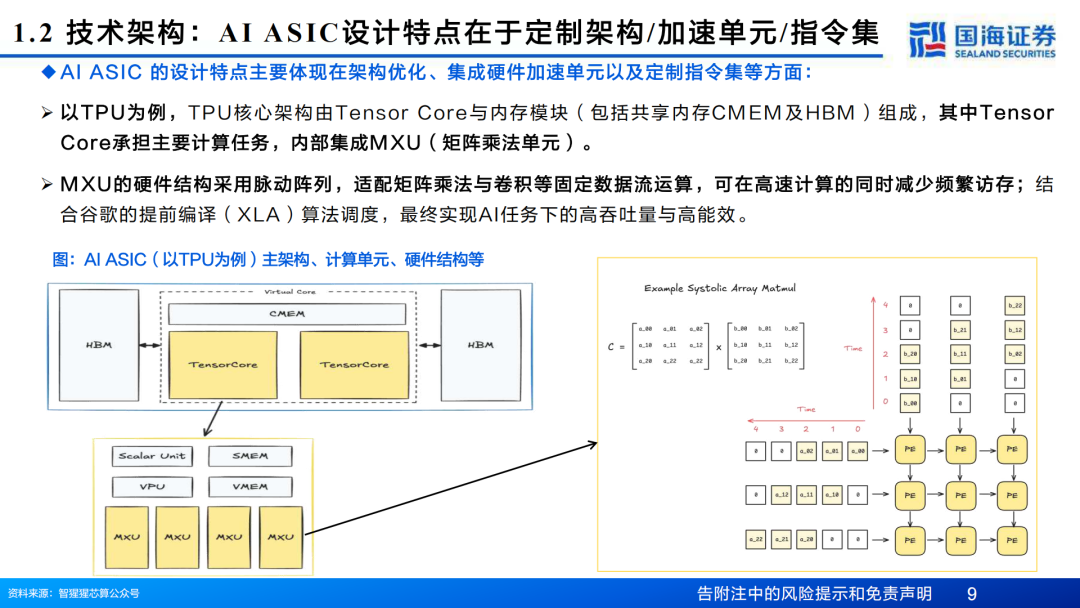
大模型中有大量矩阵乘法运算,因此会专门为矩阵计算设计硬件;由于数据搬运量很大,因此也会重新设计内存架构和数据通路。谷歌TPU里的MXU,就是专门负责矩阵乘法的计算单元。
理解ASIC,不用记TPU、NPU、LPU这些名字,没必要....
记住一个核心区别就够了,GPU追求通用,什么任务都能做;ASIC思路相反,主动放弃一部分通用性,把省下的面积和功耗集中到固定任务上。
对于每天都在重复相同计算的大型互联网公司,这个差别是很重要的。
二、为什么现在重点做推理芯片
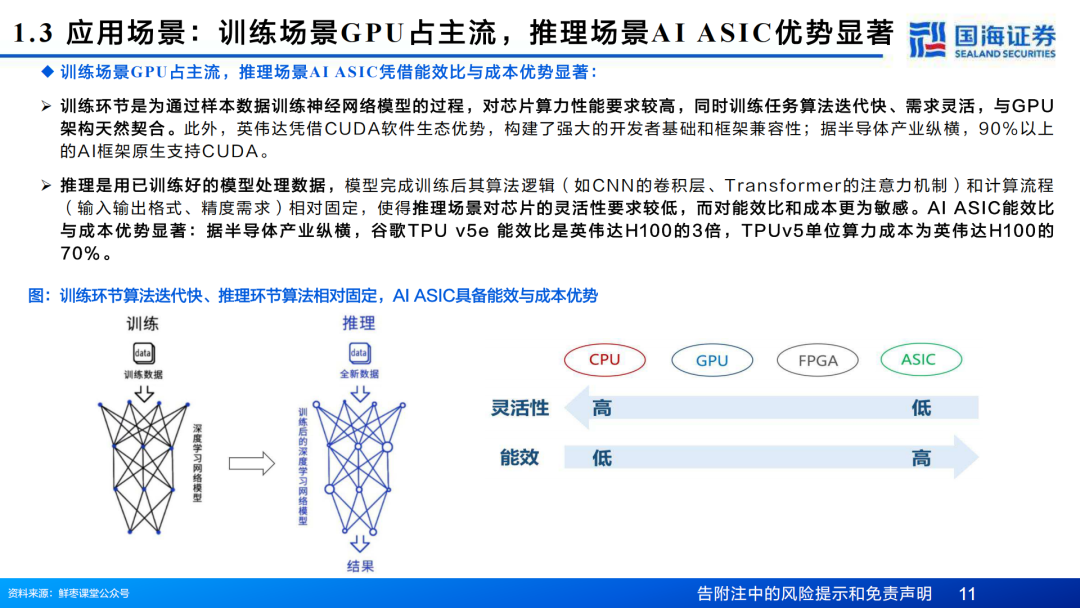
训练模型的时候,很多参数、结构和方法都还在不断调整,还没有完全固定下来。
模型可能要换结构、改算子、调整精度,训练方法也会继续变化。这时候芯片如果设计得太死,一旦算法改变,原来的硬件效率可能就下降。
GPU的通用性在这个阶段很重要。
推理不一样。一款模型正式上线以后,大量用户每天跑的是同一个模型版本,主要计算流程已经固定。业务规模又足够大的情况下,就有条件围绕这些固定任务专门做一颗芯片。
几家美国大厂现在基本都是这个思路...
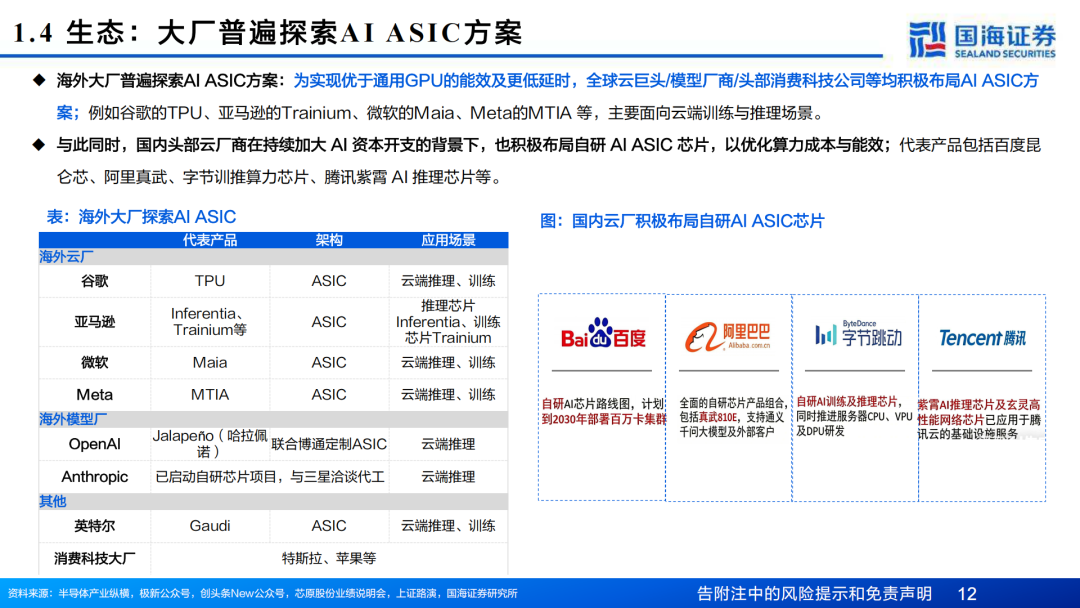
Meta每天要处理大量推荐和广告计算,所以做了MTIA;亚马逊既有自己的AI业务,还要给AWS客户提供算力,因此做Trainium;微软有Azure和Copilot,做了Maia;谷歌自己有搜索、Gemini和Google Cloud,TPU已经迭代到第八代。
不过,ASIC并不是天然优于GPU。它的优势只在特定场景里成立,前提还比较苛刻。业务规模不够大的时候,自研芯片很难把前期的研发和流片成本摊薄,算总账可能还不如直接买GPU;如果模型迭代很快、计算形态频繁变化,专用芯片也会跟不上算法演进,设计好的架构也许很快就过时了。
只有当计算任务足够稳定、调用量也足够大,ASIC在长期运行中省下的成本和能耗,才可能覆盖掉前期的高额投入。
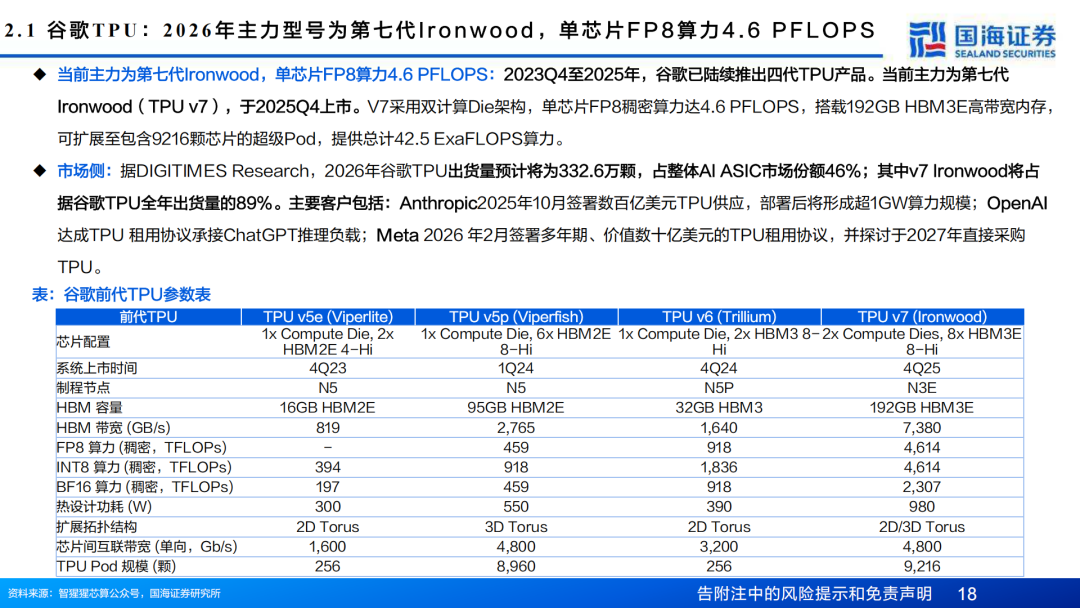
国海证券引用的测试中,谷歌TPU v5e的能效比约为H100的3倍,TPU v5单位算力成本约为H100的70%。
不同芯片的架构和测试条件并不一样,这些数字不能简单拿来判断谁“性能更强”,但可以说明大厂为什么愿意花钱开发专用芯片。
三、谷歌把训练和推理芯片分开做
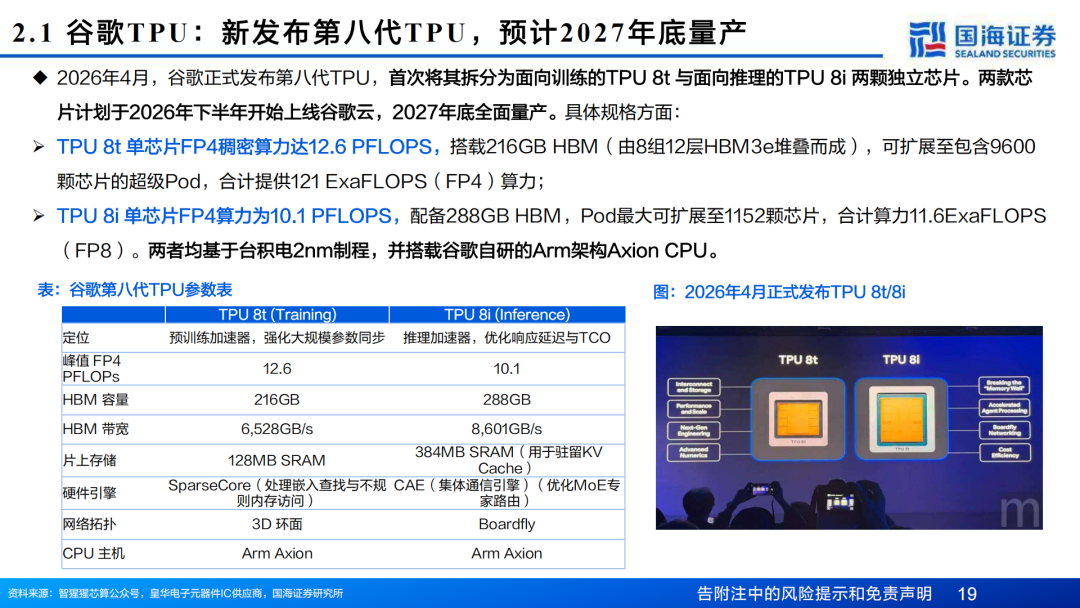
今年4月,谷歌发布第八代TPU
这一代直接分成了两款:TPU 8t负责训练,TPU 8i负责推理;
过去是一套硬件尽量多做事,现在训练和推理已经分开,各自做专用设计;
两种任务需要什么算力、多少内存、怎么连接其他芯片,都可以单独优化。
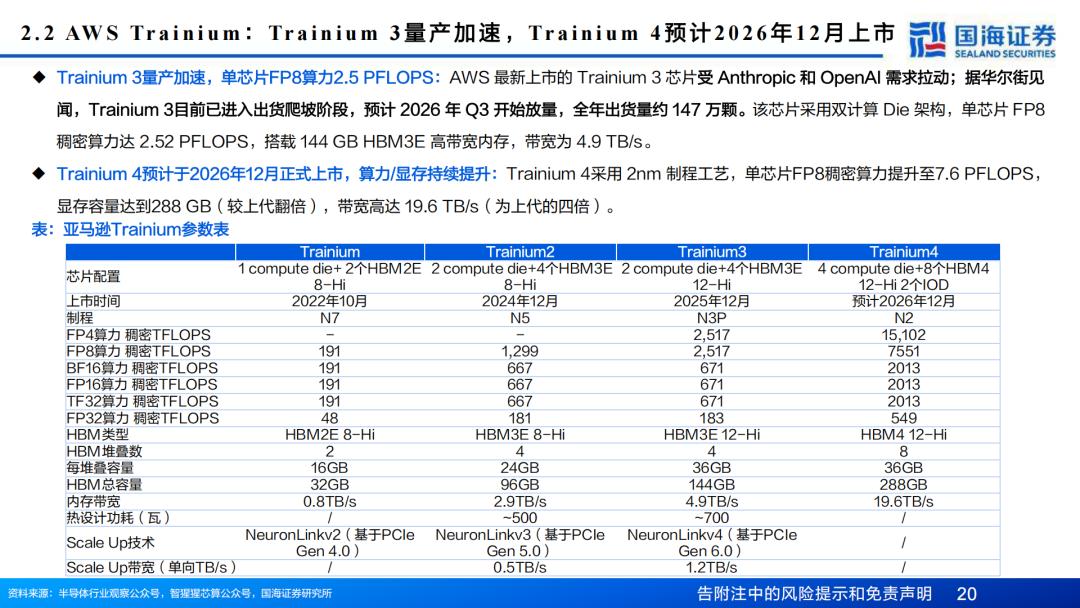
亚马逊也在继续推进Trainium。Trainium 3已经进入出货爬坡阶段,今年预计出货约147万颗,下一代Trainium 4计划在12月上市。
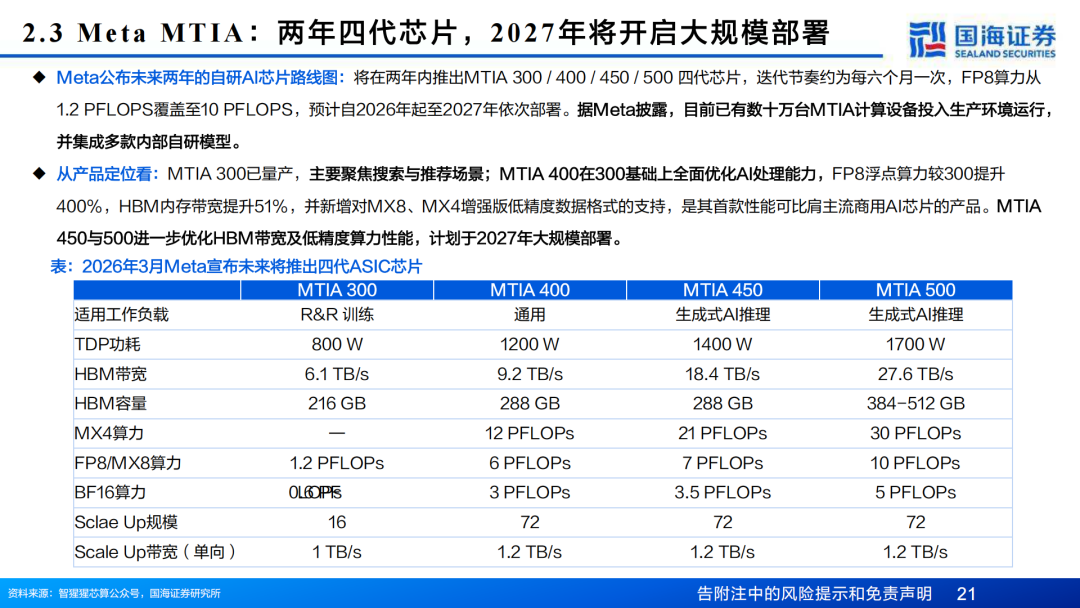
Meta的MTIA 300已经量产,目前主要跑搜索和推荐,后面的MTIA 450和500开始转向生成式AI推理。
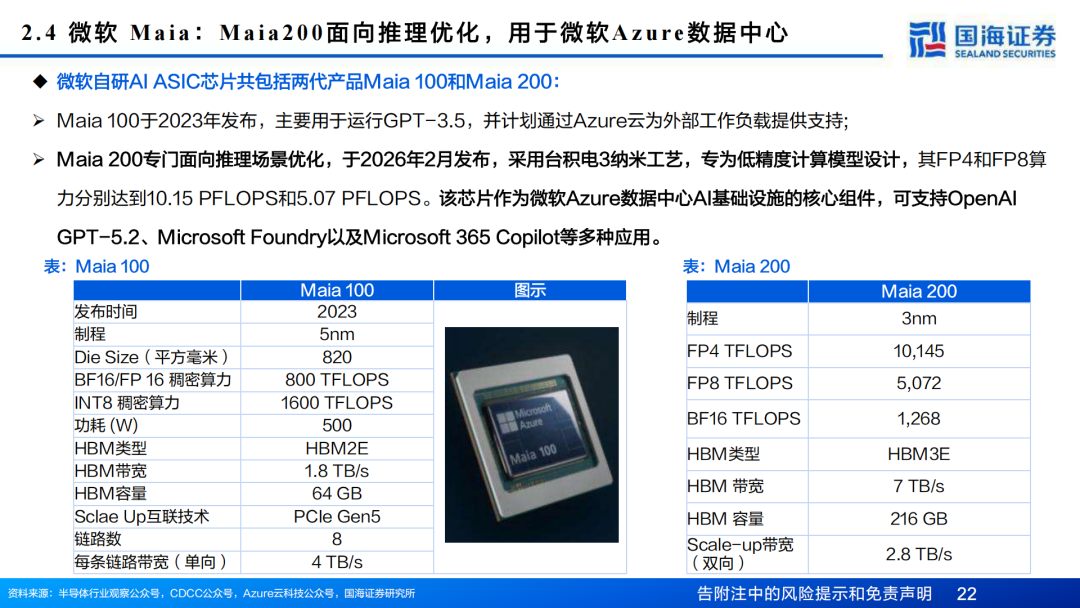
微软今年2月发布Maia 200,也是针对推理设计,目前部署在Azure数据中心,可以支持GPT-5.2、Microsoft 365 Copilot等应用。
到这个阶段,ASIC已经不是大厂内部的试验项目了。
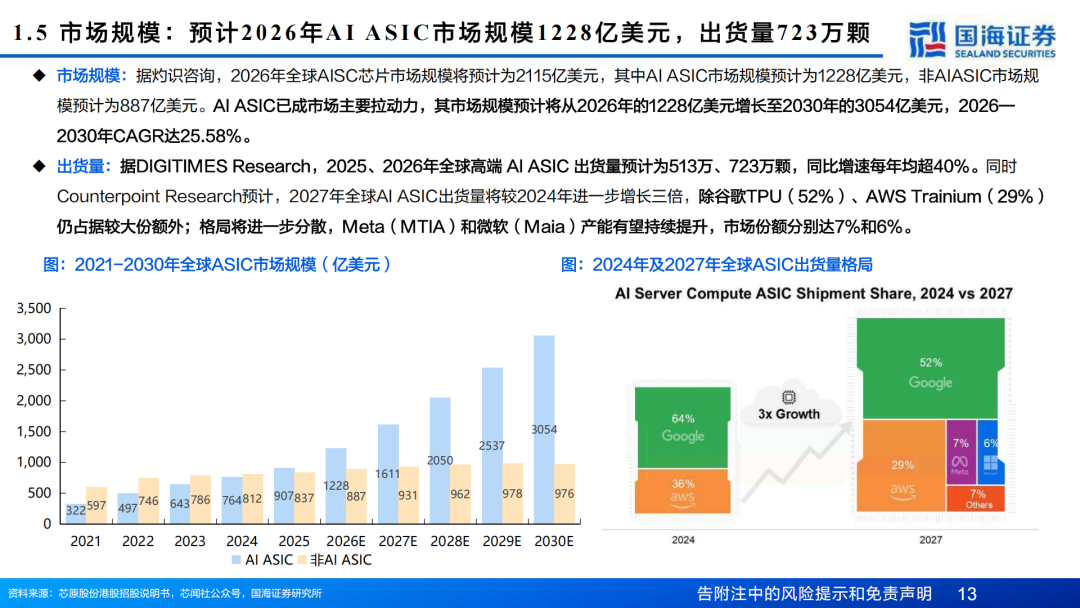
DIGITIMES Research预计,全球高端AI ASIC出货量会从2025年的513万颗增加到2026年的723万颗。
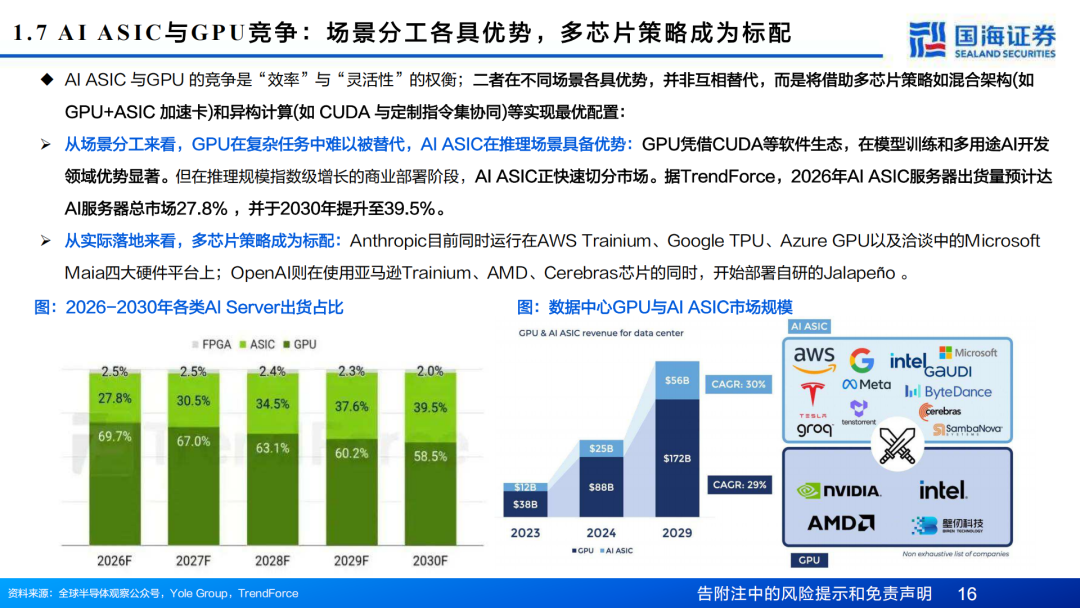
TrendForce预计,今年AI ASIC服务器占AI服务器出货量的27.8%,到2030年会提高到39.5%。
GPU还是AI算力的主力,但那些已经跑稳、不再频繁调整的任务,正改由专用芯片来承接。
四、字节阿里百度腾讯都在做自研AI芯片
国内大厂做ASIC,逻辑其实差不多
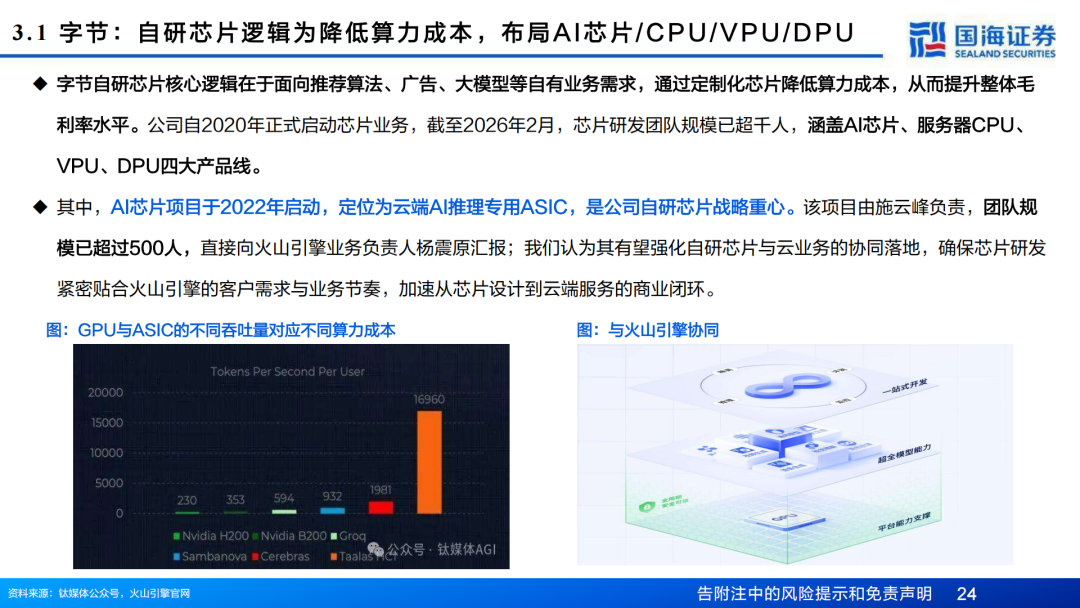
字节每天有抖音推荐、广告和豆包等大量计算任务。如果其中一部分能够换成自己的芯片,在同样的服务器和电力投入下处理更多的请求,长期算下来就有意义。
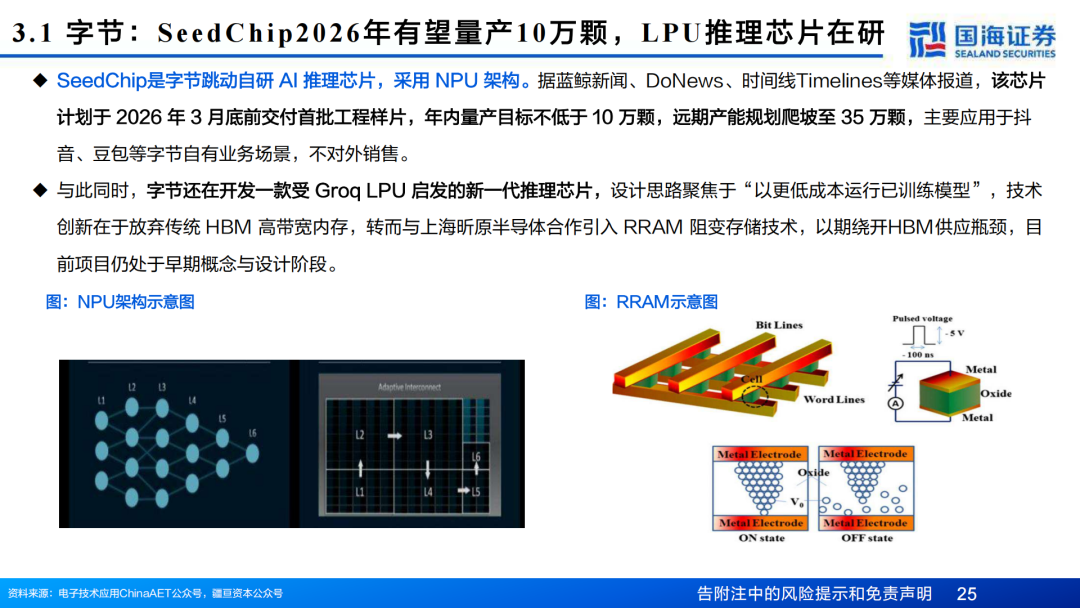
字节SeedChip采用NPU架构,年内量产目标不低于10万颗,远期规划35万颗,主要供抖音、豆包等内部业务使用,并不对外销售。
阿里的进度更快一些;
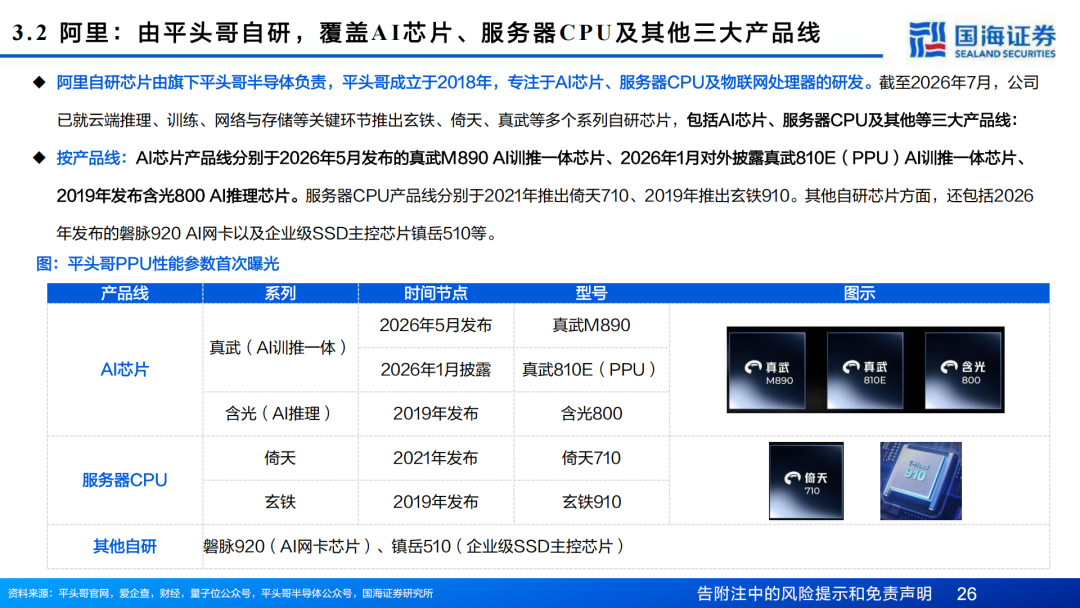
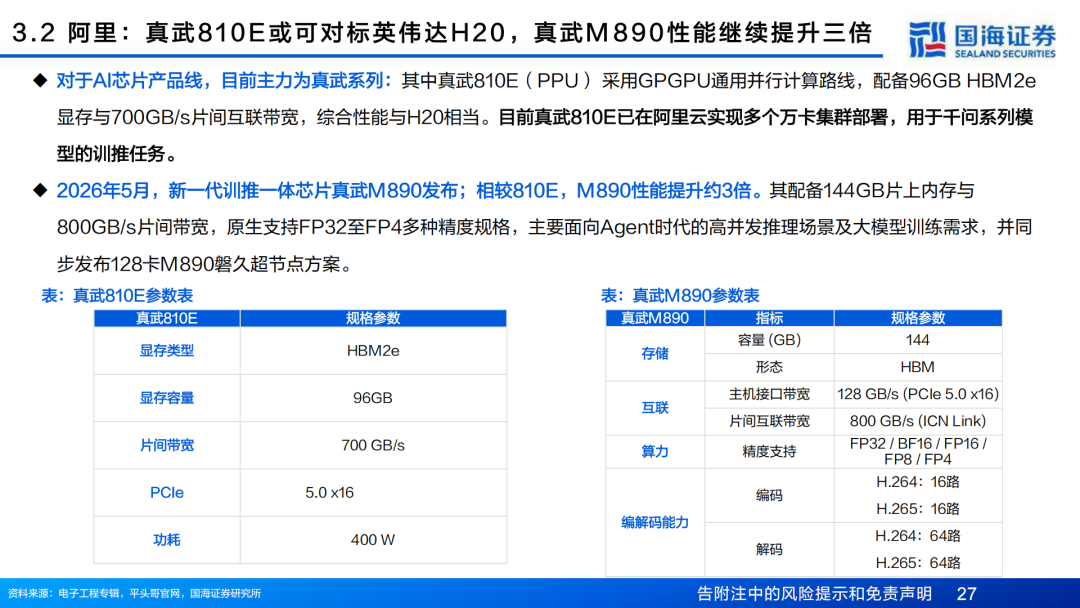
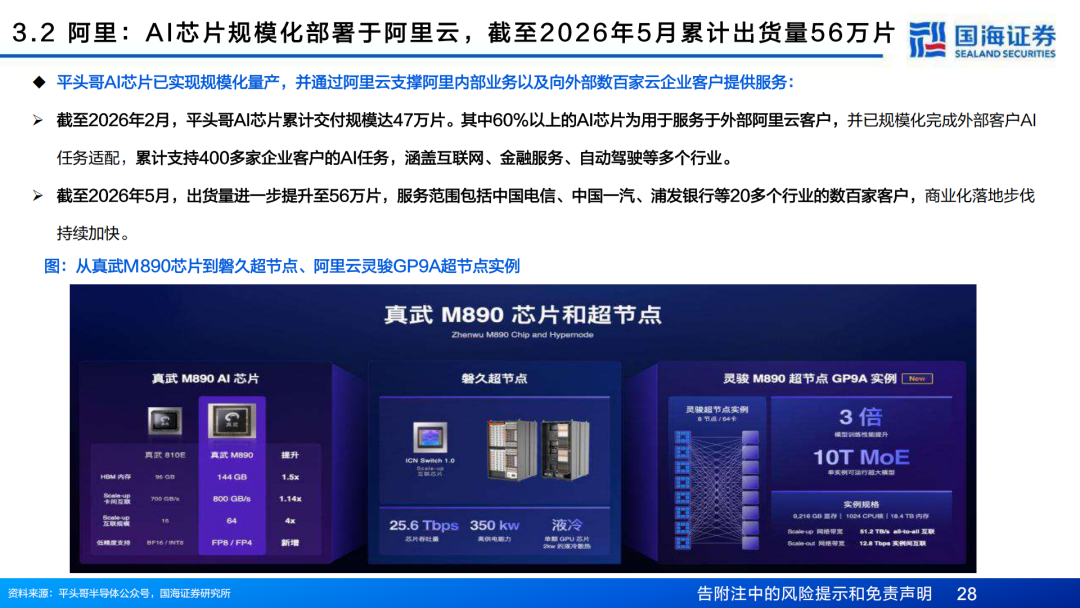
真武810E已经在阿里云部署多个万卡集群,今年5月又发布真武M890,并推出128卡磐久超节点。截至今年5月,平头哥AI芯片累计出货56万片,服务20多个行业的数百家客户。
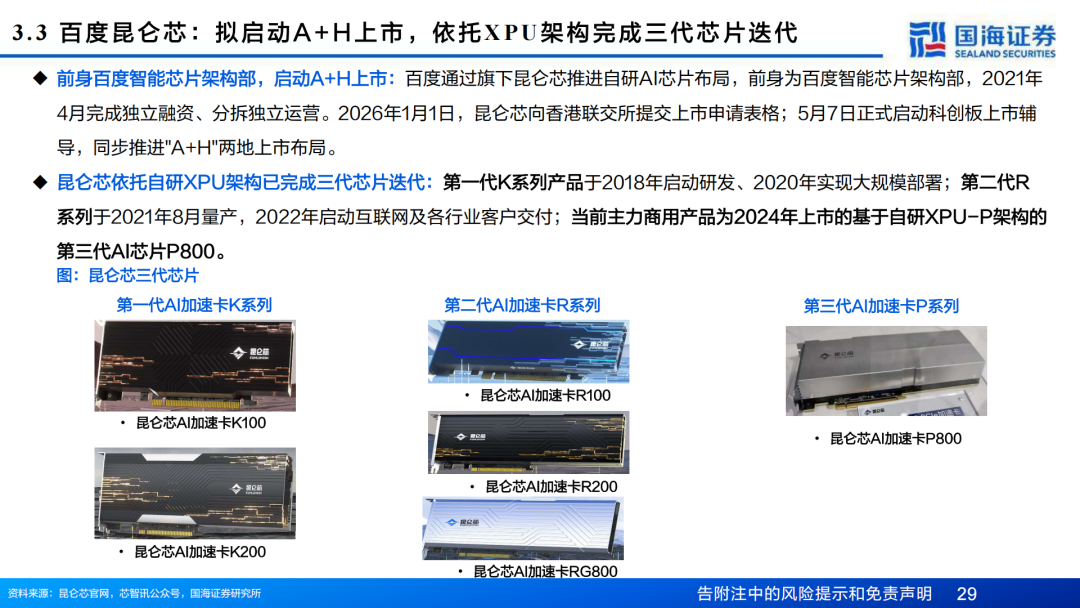
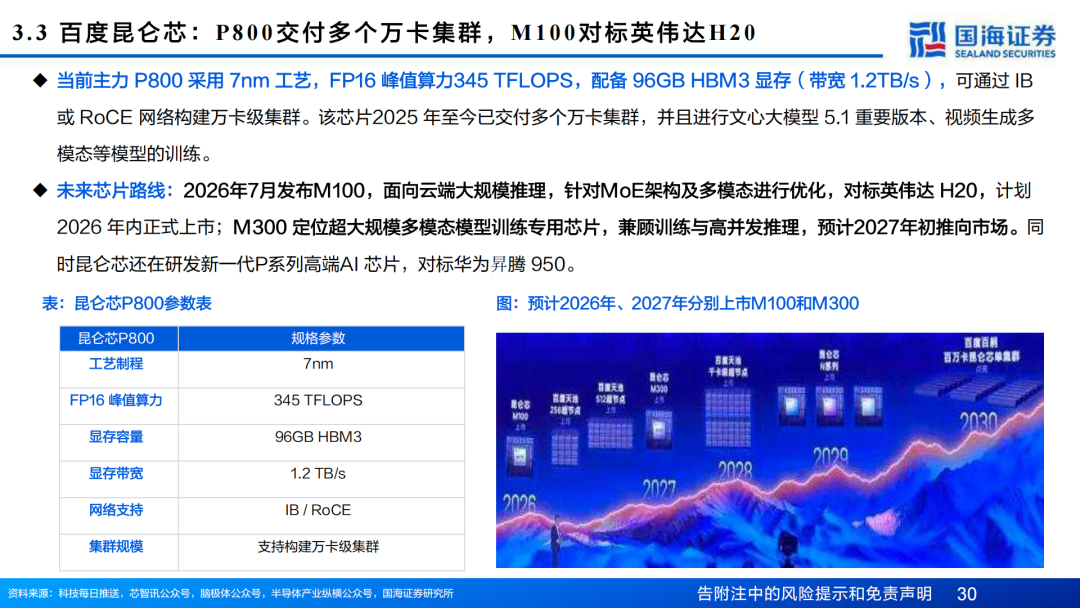
百度昆仑芯P800也已经交付多个万卡集群,7月发布的M100主要面向云端大规模推理。
腾讯也在7月发布紫霄2.0,并计划年底把自研芯片部署规模扩大到10万卡级别。
五、自研芯片是定需求,不是自己造芯片
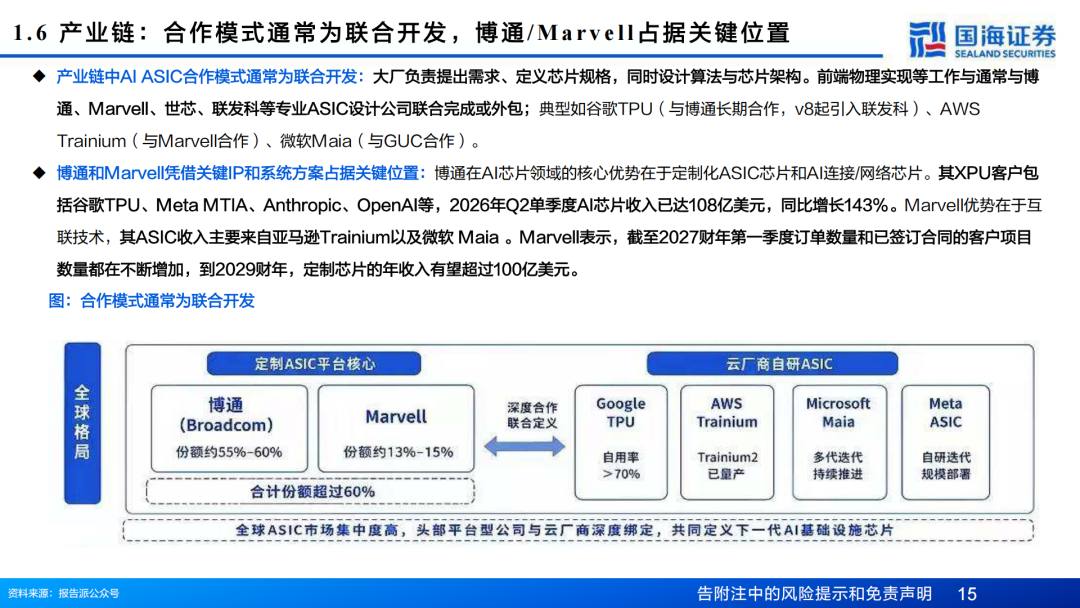
谷歌的TPU虽然叫自研芯片,但并不是说从设计到生产的每一步都是谷歌自己完成的。
更准确地说,谷歌主要负责“定义需求”。
比如:这颗芯片要用来跑什么模型?需要多大的算力?内存带宽和网络带宽要多少?功耗要控制在什么水平?这些问题确定之后,谷歌再据此去设计整体架构。
等真正进入芯片设计阶段后,很多具体工作也不是谷歌自己做完的,比如电路设计、IP模块、接口标准、芯片互联等,通常会交给专业的半导体公司来协作完成。
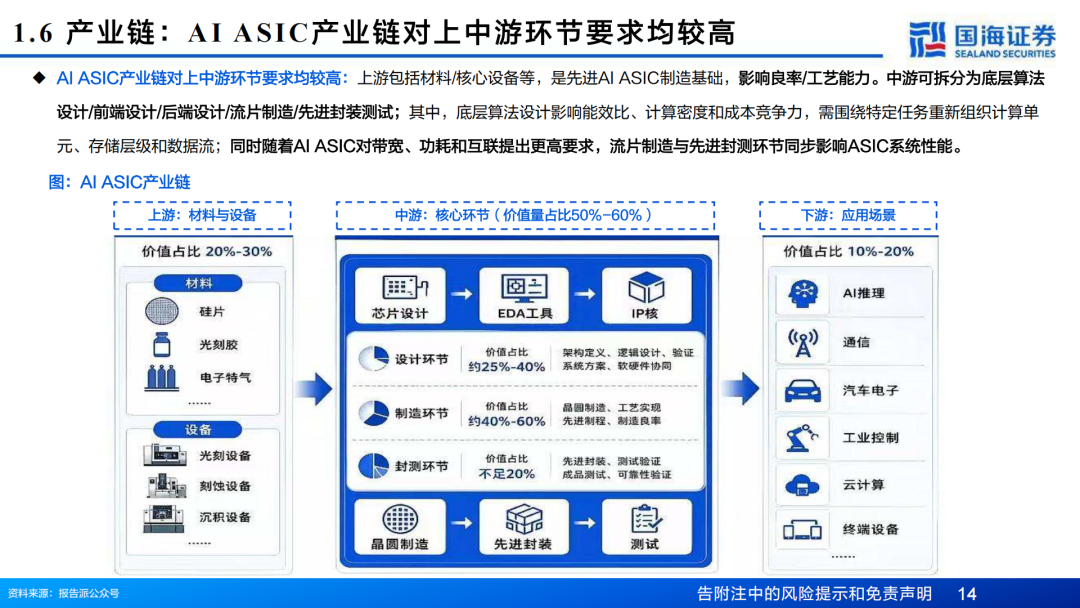
芯片设计完成以后,还要经过晶圆制造、先进封装,再和HBM、PCB、光模块、网络设备、电源、液冷组成完整服务器。
因此,ASIC的兴起,让AI服务器里的计算芯片不再由GPU一家独大,而是GPU和定制芯片开始并行。
但GPU并不会因此退出...
训练新模型需要灵活性,很多企业的算力规模也没有大到值得自己花几年时间设计芯片。真正有能力自研ASIC的,首先还是谷歌、亚马逊、Meta、微软、阿里、字节这类拥有巨大固定算力需求的平台公司。
ASIC后面能拿走多少市场,最后还是看一件很现实的事情:省下来的推理成本,能不能覆盖自研芯片本身巨大的研发和部署投入。
六、尾
ASIC产业链涉及芯片设计服务、晶圆制造、先进封装、HBM、PCB和高速互联六大环节,相关公司数量较多,本文不再逐一展开。原报告对各环节及相关公司已有详细梳理,具体业务和进展仍以公司公告等公开信息为准。
以上为行业及产业链资料梳理,仅供交流,不构成投资建议。
(科技责编:拓荒牛
 )


 晋ICP备17002471号-6