
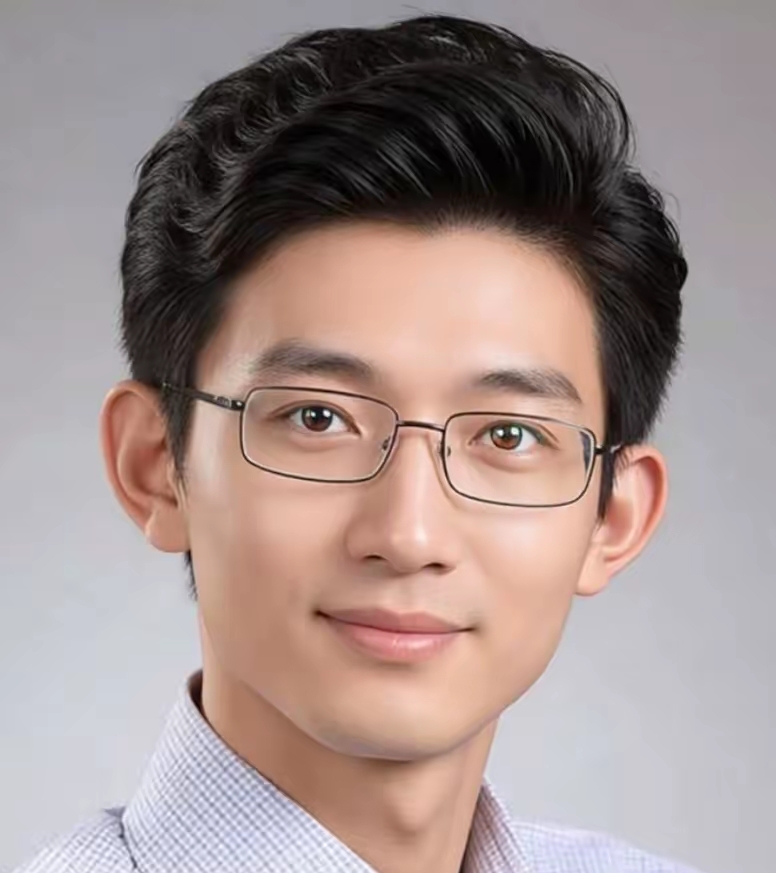
马腾宇是吉林长春人,高中就读于东北师大附中,是那种成绩从小优秀到大的孩子。
早在高二阶段,他就站上国际数学奥林匹克的赛场,也凭竞赛拿到保送资格,进入清华姚班,和陈丹琦成为同班同学。
进了姚班之后,他发现自己并不是什么都强。
数学竞赛出身的他,编程和算法是实打实的短板。同班同学杨弋是IOI金牌选手,马腾宇大一的时候经常去问他问题。杨弋推荐他看《算法导论》,他就一本一本啃下来,一边补计算机基础,一边跟着孙晓明老师做组合数学方向的研究。
这种“知道自己不会什么就去学什么”的能力,比天赋本身更稀缺。
很多天才少年栽在“装”上。明明不会,硬撑,最后撑不过去。马腾宇不装。他不会编程,就去找会的人问。他不会算法,就去啃最厚的教材。姚班那几年,他把自己从一个“数学好的竞赛生”,硬生生打磨成了一个能做计算机理论研究的学者。
2012年本科毕业,他去了普林斯顿,师从Sanjeev Arora。
这个导师来头不小。印度裔理论计算机科学家,以概率检验证明、PCP定理的研究闻名,两度获得哥德尔奖。Sanjeev带出来的学生,后来大多去了美国顶尖大学任教。马腾宇去普林斯顿那年,正好赶上深度学习爆发的前夜。
2012年,Hinton和他的学生在ImageNet比赛中凭借AlexNet碾压对手。
深度学习时代正式拉开帷幕。Sanjeev嗅觉敏锐,从2012年起就开始布局机器学习算法的研究。马腾宇进组之后,选择了非凸优化这个方向。当时大多数人还在用传统方法做凸优化问题,非凸优化在理论上是个NP-hard问题,几乎没人碰。
马腾宇和鬲融是最早一批专注解决这个问题的人。
他们研究的是:为什么深度学习里那些简单的优化算法,明明面对的是非凸问题,实际中却能表现得很好。理论解释不了的东西,他们试着去证明。凭着对非凸优化问题的系统研究,马腾宇在2018年获得了ACM博士论文奖荣誉奖,整个奖项那一年只有三个人拿到。
他的博士论文题目是《机器学习的非凸优化:设计、分析和理解》。
这篇论文提出了新的理论来支持机器学习的新趋势,介绍了证明非凸优化算法收敛性方面的重要进展,并概述了通过这些方法训练的机器学习模型的性质。
博士毕业的时候,MIT、哈佛、斯坦福、CMU、加州理工,全都给他发了助理教授Offer。
他选了斯坦福。姚期智后来在采访里专门提过这件事:“尤其是马腾宇,他刚刚毕业,能够被雇到斯坦福去,不管是中国学生还是外国学生都是非常少的。”姚期智还说,这批姚班出来的学生,“确实可以说在人工智能领域是先驱,将来一定会在该领域留下非常深刻的痕迹”。
2021年,马腾宇拿下斯隆研究奖。
这个奖在学界有个绰号,叫“诺奖风向标”。他是继鬲融之后,又一位拿到斯隆奖的姚班毕业生。鬲融是他在普林斯顿的同门师兄,也是同一个导师Sanjeev Arora带出来的。
在斯坦福教书的同时,他做了一件让很多人意外的事。
2023年,他创办了Voyage,主攻大模型嵌入模型。推出的模型在MTEB评测上超越了当时OpenAI的同类产品。一个做理论研究的学者,跑去做产品,还做得比行业巨头好,这件事本身就不太寻常。
2024年,他又干了一件震动学界的事。
他用数学严格证明:只要思维链推理的token足够多,Transformer模型理论上可以求解任意复杂问题。这项成果在整个大模型学界引发了巨大讨论。很多人做AI是在“炼丹”,调参数、试方法,成了就发论文。马腾宇做的是从数学底层去解释:为什么这东西能work,它的边界在哪里。
2025年,他入选福布斯中国最具影响力华人精英TOP 100。
一个在斯坦福当教授、同时经营AI创业公司的人,一边发论文,一边做产品,一边带学生。这种“理论指导工程”的路线,在当下的AI圈子里并不多见。很多人要么纯做学术,要么纯做产品。马腾宇选了中间那条路,而且两条路都走得通。
回过头看他在姚班的那段日子,有一个细节挺有意思。
他说自己大一刚入学的时候,编程和算法都不太行,经常去问同学杨弋。杨弋是IOI金牌,按理说差距摆在那儿。马腾宇没有因为“我是数学竞赛保送来的”就端着架子。不会就是不会,问就是了。这种心态,比智商更重要。
他的导师Sanjeev Arora对他的评价是:聪慧程度超乎想象,甚至超过自己。
Sanjeev本人是1986年印度联合入学考试的第一名,全印度状元。一个状元说自己学生比自己聪明,这话的分量不一样。
(财经责编:拓荒牛
 )


 晋ICP备17002471号-6